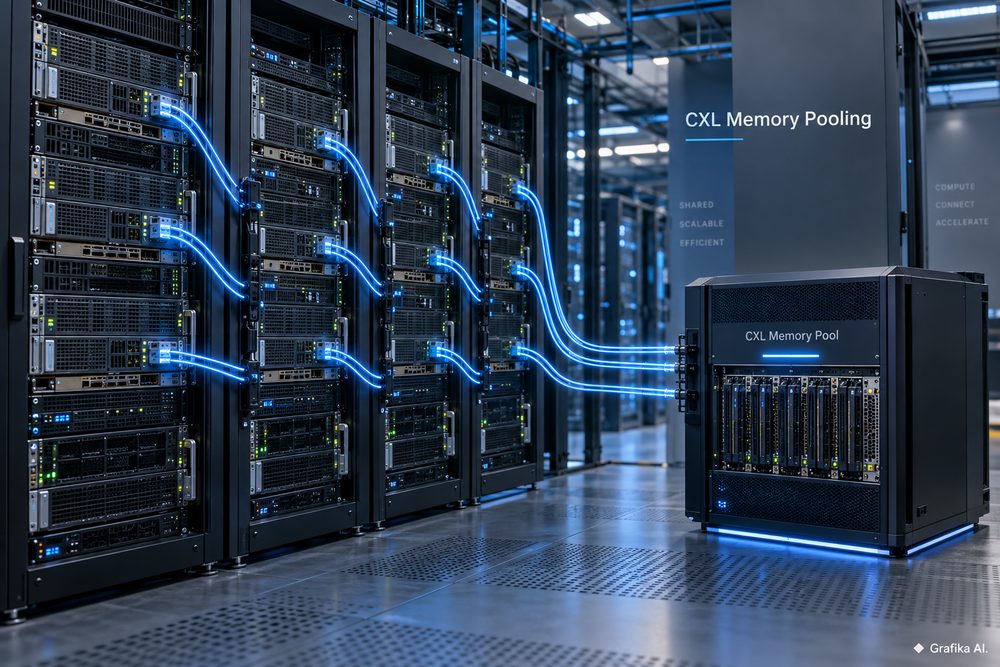
Serwer może mieć wolne setki gigabajtów RAM-u i jednocześnie stać obok maszyny, która właśnie dobija do limitu pamięci. Klasyczna architektura nic z tym nie zrobi: moduły DDR5 są fizycznie przypisane do kontrolera pamięci konkretnego procesora. CXL zmienia przede wszystkim tę zasadę własności pamięci. Pozwala dołożyć pamięć poza kanałami DDR, a w bardziej rozbudowanej konfiguracji zbudować pulę, z której pojemność przydziela się różnym hostom.
Nie oznacza to jednak, że można wyrzucić DIMM-y z serwerów i postawić obok jedną wielką skrzynkę z RAM-em. Lokalna pamięć DDR nadal ma przewagę tam, gdzie liczy się minimalne opóźnienie i bardzo duża przepustowość. CXL jest ciekawszy jako drugi poziom pamięci, rozszerzenie pojemności oraz mechanizm ograniczający stranded memory, czyli RAM kupiony i zasilany, ale niewykorzystywany przez większość czasu.
Druga rzecz, która bywa źle tłumaczona, dotyczy PCI Express. Pamięć CXL rzeczywiście jest podłączana liniami używanymi przez PCIe, lecz procesor nie traktuje jej jak dysku NVMe ani zwykłego urządzenia I/O. CXL wykorzystuje warstwę fizyczną PCIe, ale dokłada własne protokoły semantyki pamięci i spójności cache. To właśnie ten szczegół sprawia, że CPU może wykonywać normalne odczyty i zapisy pod adresami znajdującymi się fizycznie poza modułami DIMM.
CXL nie jest zwykłym urządzeniem PCIe — tak naprawdę CPU dociera do pamięci
Najłatwiej zrozumieć CXL, rozdzielając trzy protokoły działające w ramach standardu:
- CXL.io odpowiada m.in. za wykrywanie urządzenia, konfigurację, obsługę błędów i funkcje I/O. Jest mocno związany z klasycznym PCIe.
- CXL.cache pozwala urządzeniu, np. akceleratorowi, korzystać spójnie z pamięci hosta.
- CXL.mem obsługuje właściwe operacje pamięciowe pomiędzy procesorem a pamięcią znajdującą się w urządzeniu CXL.
Typowy moduł rozszerzający pamięć to CXL Type 3. Nie jest akceleratorem. Zawiera kontroler CXL oraz DRAM, a procesor korzysta z tej pamięci przede wszystkim za pośrednictwem CXL.mem.
Ścieżka pojedynczego odczytu wygląda w uproszczeniu tak:
- aplikacja odwołuje się do adresu w swojej przestrzeni pamięci;
- po translacji adresu CPU ustala, że dany zakres znajduje się w Host-Managed Device Memory urządzenia CXL;
- żądanie zostaje skierowane do portu CXL procesora;
- przez fizyczne linie PCIe przesyłana jest transakcja CXL.mem, a nie zwykła operacja odczytu z urządzenia PCIe;
- kontroler na module CXL odczytuje właściwe dane z własnej pamięci DDR;
- linia danych wraca do procesora i może trafić do jego cache.
Dla aplikacji rezultat może wyglądać jak zwykły dostęp do pamięci. Nie ma kopiowania danych przez read() jak z pliku ani obowiązkowego przechodzenia przez stos blokowego I/O.
Dlaczego wykorzystano właśnie PCIe? Bo współczesne procesory serwerowe już mają dużą liczbę szybkich linii wyprowadzonych poza socket. Budowanie osobnego interfejsu elektrycznego dla pamięci rozszerzanej oznaczałoby kolejne PHY, złącza, ścieżki na płycie i zupełnie nowy ekosystem sprzętu. CXL wykorzystuje istniejącą infrastrukturę PCIe, ale zmienia sposób, w jaki przesyłane przez nią dane są interpretowane.
W CXL 2.0 połączenie pracuje na warstwie fizycznej PCIe 5.0, czyli do 32 GT/s na linię. Przy kodowaniu 128b/130b daje to teoretycznie około:
- 3,94 GB/s na jedną linię w jednym kierunku,
- 31,5 GB/s dla x8,
- 63 GB/s dla x16.
To wartości warstwy łącza. Realna przepustowość pamięci będzie mniejsza z powodu narzutów protokołu, właściwości kontrolera CXL, konfiguracji DRAM, wzorca dostępu i obciążenia.
CXL 3.x przechodzi na fizyczną warstwę PCIe 6.0 i 64 GT/s, a opublikowany w listopadzie 2025 r. standard CXL 4.0 wykorzystuje fundament PCIe 7.0 i podnosi szybkość do 128 GT/s. Nie należy jednak kupować infrastruktury na podstawie numeru najnowszej specyfikacji. W 2026 r. bardzo istotna część dostępnych platform produkcyjnych nadal opiera się na CXL 2.0.
Przykładowo platformy Intel Xeon 6 mogą udostępniać do 64 linii CXL 2.0 przy 32 GT/s, a AMD EPYC 9005 również pozwala przeznaczyć do 64 linii na CXL 2.0. Sama obecność slotu PCIe 5.0 x16 nie wystarcza. Muszą zgadzać się procesor, root port, płyta główna, BIOS/UEFI, firmware urządzenia i lista konfiguracji zatwierdzonych przez producenta serwera.
To częsty i kosztowny błąd zakupowy: zwykły switch PCIe 5.0 nie staje się switchem CXL tylko dlatego, że obsługuje właściwą prędkość linii. Switch CXL musi rozumieć dodatkowe mechanizmy CXL.mem i CXL.cache.
Od ekspandera do memory poolingu: kiedy RAM przestaje należeć do jednego hosta
Pojedynczy moduł CXL podłączony bezpośrednio do serwera jeszcze nie tworzy memory poolingu. To przede wszystkim memory expansion: dodatkowe 128, 256 GB albo większa pula DRAM widoczna dla konkretnego hosta.
Produkcyjnym przykładem jest Samsung MD220: urządzenie CXL 2.0, PCIe 5.0, EDSFF E3.S 2T, dostępne m.in. w pojemnościach 128 i 256 GB. Moduły tej klasy zajmują jednak zasoby I/O. W serwerze trzeba znaleźć dla nich odpowiednie linie procesora, zatoki, zasilanie i chłodzenie. W konstrukcjach E3.S te same miejsca mogą być potrzebne na dyski NVMe. Rozbudowa pamięci może więc oznaczać mniejszą liczbę lokalnych SSD albo konieczność wyboru innego chassis.
Prawdziwy memory pooling dodaje switch CXL oraz mechanizm zarządzający przydziałem zasobów.
Schemat wygląda wtedy tak:
serwery → porty CXL → switch CXL → urządzenia pamięci CXL.
Fabric Manager wie, jakie urządzenia znajdują się za switchem, jakie zasoby są dostępne i do których wirtualnych hierarchii mają zostać przypisane. Zamiast kupować maksymalną konfigurację DIMM dla każdego węzła, administrator może utrzymywać lokalny RAM na potrzeby najgorętszych danych i dodatkową pojemność w warstwie CXL.
Trzeba jednak odróżnić pooling od sharingu.
W CXL 2.0 fizyczne urządzenie Type 3 może działać jako Multi-Logical Device, MLD. Standard pozwala wydzielić maksymalnie 16 izolowanych urządzeń logicznych. Różne hosty mogą w tym samym czasie korzystać z przydzielonych im części fizycznego urządzenia, ale nie oznacza to automatycznie współdzielenia tych samych bajtów pamięci przez wszystkie procesory.
CXL 2.0 pozwala również odłączyć zasób od jednej domeny i przydzielić go innej. Taki pooling jest więc bliższy dynamicznemu partycjonowaniu RAM-u niż jednej ogromnej pamięci, do której wszystkie serwery jednocześnie zapisują bez ograniczeń.
Dopiero CXL 3.0 mocno rozszerzył fabric: pojawiło się wielopoziomowe przełączanie, rozbudowane topologie, komunikacja peer-to-peer i bardziej zaawansowane mechanizmy coherent memory sharing pomiędzy hostami. Specyfikacja przewiduje fabric liczący do około 4 tys. portów. To ważne architektonicznie, ale nie należy utożsamiać możliwości dokumentu CXL 3.x z funkcjami gotowego serwera stojącego dziś w szafie.
W praktyce najbardziej sensowny scenariusz jest prostszy. Załóżmy, że klaster ma kilkanaście węzłów. Każdy został wyposażony w RAM pod swój indywidualny szczyt obciążenia, lecz szczyty występują o różnych porach. Suma maksymalnego wykorzystania każdego serwera może więc wynosić np. 10 TB, podczas gdy rzeczywisty maksymalny pobór całego klastra w tej samej minucie nigdy nie przekracza 6–7 TB.
W klasycznej architekturze trzeba mimo tego fizycznie rozmieścić blisko 10 TB między poszczególnymi hostami. CXL daje możliwość przesunięcia części nadmiarowej pojemności do warstwy współdzielonej.
Tu znajduje się prawdziwa korzyść ekonomiczna. Nie chodzi o to, że jeden gigabajt CXL zawsze kosztuje mniej od jednego gigabajta RDIMM. Do rachunku dochodzą kontrolery CXL, switche, zatoki E3.S, firmware, dodatkowe zużycie energii oraz wsparcie producenta serwera. Ceny infrastruktury poolingowej są zresztą najczęściej ustalane w wycenach OEM i integratorów, a nie w prostym publicznym cenniku PLN/GB.
Opłacalność bierze się z czegoś innego: można ograniczyć ilość pamięci kupowanej „na wszelki wypadek” osobno dla każdego hosta.
Przed projektem warto policzyć dwie liczby:
- sumę indywidualnych szczytów zużycia pamięci wszystkich serwerów;
- największe jednoczesne zużycie pamięci przez cały klaster.
Jeżeli obie wartości są niemal identyczne, pooling niewiele zmieni — maszyny potrzebują RAM-u w tym samym czasie. Jeżeli różnica jest duża, istnieje realny zasób stranded memory, który można próbować odzyskać przez CXL.
CXL daje pojemność, ale za dodatkowe nanosekundy. Tego nie da się ominąć marketingiem
Największym błędem przy projektowaniu CXL jest policzenie tylko gigabajtów. Pamięć CXL nie ma takich samych parametrów jak DRAM podłączony bezpośrednio do kontrolera procesora.
Dodatkowa droga przez port CXL, PHY, ewentualny switch i kontroler pamięci urządzenia zwiększa opóźnienie. Skala zależy od procesora, urządzenia, liczby switchy, firmware i wzorca dostępu.
Dobry punkt odniesienia daje test rozwiązania Samsung CMM-D opublikowany w 2026 r. W konkretnej badanej platformie lokalny DDR5 osiągał około 144 ns opóźnienia, podczas gdy lokalnie dostępna pamięć CXL CMM-D około 254 ns. W teście przepustowości dla samych odczytów DDR5 dochodził do około 278 GB/s, a CMM-D do 52,4 GB/s.
Nie są to uniwersalne wartości dla każdego CXL. Pokazują za to skalę różnicy, którą trzeba założyć podczas projektu: CXL znajduje się bliżej DRAM-u niż SSD, ale nadal nie jest równoważny lokalnemu DIMM-owi.
Z tego powodu źle działają na nim przede wszystkim gorące struktury danych wykonujące dużą liczbę losowych zależnych od siebie odczytów — klasyczny pointer chasing. Procesor nie może wtedy łatwo ukryć dodatkowego opóźnienia prefetchingiem.
Lepiej wyglądają:
- duże bazy in-memory, gdy CXL przechowuje chłodniejszą część working setu;
- cache o bardzo dużej pojemności;
- analityka i HPC, w których dostęp jest bardziej przewidywalny;
- hosty wirtualizacyjne ograniczane przez pojemność RAM na rdzeń;
- AI inference, w tym wybrane zastosowania związane z dużymi buforami i KV cache;
- środowiska, w których dodatkowa pojemność pozwala wykorzystać CPU, które wcześniej czekały z powodu braku RAM-u.
Co ciekawe, CXL nie musi zawsze obniżać całkowitej wydajności. Jeśli aplikacja jest ograniczana nie tylko pojemnością, ale również liczbą dostępnych kanałów pamięci, dodatkowe linki CXL mogą dostarczyć dodatkową równoległą przepustowość.
W testach Intel/Micron na Xeon 6 6900P wykorzystano 12 kanałów DDR5-6400 oraz osiem modułów Micron CZ122 E3.S x8. Linux rozkładał strony pomiędzy DDR5 i CXL przez weighted interleaving. Dodanie CXL zwiększyło przepustowość odczytu o około 24%, a przy mieszanym odczycie i zapisie maksymalnie o 39%. Średni geometryczny wzrost wydajności badanych workloadów HPC i AI wyniósł około 24%.
To ważna wskazówka: najlepszy projekt często nie brzmi „DDR albo CXL”, lecz DDR + CXL z kontrolowanym placementem stron.
W Linuksie pamięć CXL może zostać udostępniona m.in. jako zwykła pamięć przez mechanizm memory hotplug albo jako Device DAX. Przy klasycznej konfiguracji system może widzieć ją jako osobny węzeł NUMA bez przypisanych rdzeni CPU. Dzięki temu administrator lub aplikacja może świadomie zdecydować, co trzyma lokalnie, a co przenieść na wolniejszy poziom.
Na hoście testowym pierwsza diagnostyka powinna obejmować co najmniej:
cxl list -M -H— urządzenia CXL i ich stan;numactl --hardware— topologię NUMA i dostępne węzły;daxctl list— jeśli wykorzystywany jest Device DAX;- test przepustowości i opóźnień, np. Intel Memory Latency Checker albo STREAM;
- przede wszystkim test właściwej aplikacji przy realnym working secie.
Sam STREAM też potrafi wprowadzić w błąd. Baza danych, JVM, Redis, serwer wirtualizacyjny i model AI mają zupełnie inne proporcje losowych odczytów, zapisów oraz trafień w cache CPU. Decyzję o CXL należy podejmować na wyniku aplikacji, nie na jednym wykresie GB/s.
Drugi problem to BIOS i firmware. Procesor z obsługą CXL oraz karta zgodna z CXL 2.0 nadal nie gwarantują działającej konfiguracji. Serwer musi mieć właściwie wyprowadzone porty, odpowiednie tablice ACPI, obsługę decoderów CXL, zatwierdzony firmware i chłodzenie. W praktyce przy zakupach w Polsce bezpieczniej zaczynać od listy kompatybilności całego serwera OEM niż od atrakcyjnie wyglądającego modułu pamięci kupionego oddzielnie.
Trzeci problem to utrzymanie. Lokalny RDIMM jest prostym elementem z punktu widzenia topologii. Pool CXL dodaje kolejną domenę awarii: switch, fabric manager, kontrolery urządzeń, firmware i połączenia. Trzeba monitorować błędy RAS, degraded performance i stan poszczególnych memdevów. Przy rozwiązaniu produkcyjnym hot-add i hot-remove również należy przetestować przed uruchomieniem usługi, a nie zakładać, że skoro funkcję opisuje standard, to każda kombinacja BIOS-u, systemu i urządzenia wykona ją identycznie.
FAQ: CXL i memory pooling w praktyce
Czy pamięć CXL zastępuje zwykły RAM DDR5?
Nie. W większości sensownych projektów lokalny DDR5 pozostaje najszybszym poziomem pamięci, a CXL dodaje pojemność lub drugi tier. Zastąpienie całego lokalnego RAM-u pamięcią CXL pogorszyłoby parametry wielu workloadów wrażliwych na latency.
Czy wystarczy wolny slot PCIe 5.0 x16?
Nie. Procesor i konkretny root port muszą obsługiwać CXL, podobnie jak BIOS/UEFI oraz konstrukcja serwera. Zwykły slot PCIe 5.0 nie gwarantuje możliwości podłączenia pamięci CXL.
Czy CXL Type 3 działa jak bardzo szybki dysk?
Nie. To urządzenie pamięciowe. Po odpowiednim skonfigurowaniu CPU może wykonywać zwykłe operacje load/store do zakresu adresowego znajdującego się na urządzeniu. Nie jest to blokowe I/O znane z NVMe.
Czy CXL 2.0 umożliwia memory pooling?
Tak. Wprowadził switching, pooling oraz urządzenia MLD. Pamięć można dzielić na izolowane zasoby logiczne i przydzielać je hostom. Nie należy jednak utożsamiać tego z pełnym, jednoczesnym współdzieleniem tych samych linii pamięci przez wiele hostów — takie scenariusze zostały znacznie rozwinięte w CXL 3.x.
Czy pamięć z puli można przenosić między serwerami bez restartu?
Standard przewiduje mechanizmy dynamicznego zarządzania i hot-plug, a późniejsze generacje rozwijają Dynamic Capacity Devices. W produkcji możliwość wykonania tego bez przestoju zależy jednak od pełnego stosu: urządzenia, switcha, firmware hosta, systemu operacyjnego i aplikacji. Nie należy wpisywać live reallocation do SLA bez wcześniejszego testu konkretnej konfiguracji.
Czy CXL zawsze będzie wolniejszy od lokalnego DDR5?
Pojedynczy dostęp ma zwykle większe opóźnienie. Jednocześnie dodatkowe linki CXL mogą zwiększyć całkowitą przepustowość systemu, jeżeli workload potrafi równolegle korzystać z DDR i CXL. Wyniki Intel/Micron pokazują, że odpowiednie interleaving i placement stron potrafią dać wzrost wydajności zamiast spadku.
Kiedy memory pooling nie ma sensu?
Gdy wszystkie serwery potrzebują maksymalnej ilości pamięci jednocześnie, aplikacje są ekstremalnie wrażliwe na latency albo infrastruktura ma tylko kilka hostów i oszczędność stranded memory nie pokrywa kosztu switcha oraz dodatkowej złożoności. W takim środowisku zwykłe RDIMM-y są prostsze i często szybsze.
Jak sprawdzić, czy firma rzeczywiście potrzebuje CXL?
Zbierz wykorzystanie RAM każdego hosta w interwale co najmniej minutowym przez pełny cykl obciążenia biznesowego. Porównaj sumę indywidualnych maksimów z maksymalnym jednoczesnym wykorzystaniem pamięci przez cały klaster. Następnie sprawdź latency sensitivity aplikacji i potwierdź obsługę CXL w dokumentacji konkretnego modelu serwera.
Pierwszy krok przed zakupem nie powinien więc polegać na szukaniu ceny modułu CXL. Najpierw trzeba zmierzyć stranded memory. Jeżeli suma indywidualnych szczytów hostów jest wyraźnie większa od rzeczywistego jednoczesnego zapotrzebowania klastra, wykonaj pilotaż CXL na dwóch poziomach pamięci: lokalny DDR dla hot pages i CXL dla capacity tier. Jeżeli szczyty występują równocześnie albo aplikacja mocno reaguje na dodatkowe 100–200 ns dostępu, najpierw dołóż lokalny RAM i nie komplikuj infrastruktury switchem CXL.
Więcej na ten temat na stronie: https://it-buzz.pl